
如何在SQL中结合GROUP BY优化大数据量去重导出
在sql中结合group by优化大数据量去重导出,核心策略是利用group by的聚合特性配合count()或min()/max()来识别并保留唯一记录,同时必须为参与分组和过滤的列建立复合索引以加速扫描。具体做法是创建包含去重依据列和排序/过滤列的联合索引,执行带有where前置过滤和limit分批导出的查询,这样可以将内存占用降至最低并避免全表锁。
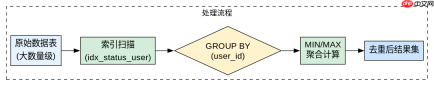
如何构建支持高效去重的复合索引
构建复合索引的关键在于将“去重依据列”放在最左侧,并将“高频过滤条件列”紧随其后,从而利用索引覆盖(Index Covering)避免回表。例如,若需按user_id去重且常按status筛选,应创建(status, user_id)索引而非仅对user_id建单列索引。这种结构允许数据库引擎在索引树中直接跳过重复键值,大幅减少I/O操作。
CREATE INDEX idx_status_user ON orders (status, user_id);
SELECT user_id, MIN(order_date) as first_order
FROM orders
WHERE status = 'completed'
GROUP BY user_id;
-- 预期结果:仅返回每个用户的第一笔完成订单,利用索引快速定位
如何通过窗口函数替代传统GROUP BY实现更灵活的去重
当需要保留去重后的完整行数据(而不仅是聚合值)时,使用RANK()或DENSE_RANK()窗口函数比传统GROUP BY更具优势。传统GROUP BY会丢失非分组列的信息,而窗口函数可在不合并行的情况下标记重复项。配合CTE(公共表表达式)和WHERE rn = 1过滤,可实现高性能去重导出,尤其适合需要保留时间戳、金额等详细字段的场景。
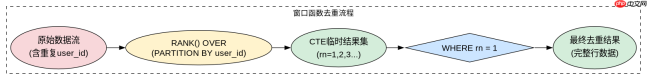
WITH ranked_orders AS (
  SELECT *, RANK() OVER(PARTITION BY user_id ORDER BY order_date DESC) as rn
  FROM orders
  WHERE status = 'completed'
)
SELECT * FROM ranked_orders WHERE rn = 1;
-- 预期结果:每个用户最新的一笔完成订单,保留所有原始字段
当GROUP BY遇到空值NULL时会如何处理去重逻辑
在SQL标准中,GROUP BY将所有NULL值视为同一个组,即多个NULL会被聚合成一行。这意味着如果去重依据列存在NULL,所有NULL记录将被合并为一条输出,可能导致数据丢失或统计偏差。为避免此问题,应在GROUP BY前使用COALESCE()将NULL替换为默认值,或在HAVING子句中显式排除NULL组,确保去重逻辑符合业务预期。技术YY(原文出处)站长夜观天象:今日宜写原创,忌采集,采集狗今日运势:暗链缠身。 出处:www.jishuyy.com。
